在企业数字化建设中,AIGC(AI内容生成) 、端云混合代码生成、企业Agent(AI智能体)、以及VDI(虚拟桌面基础设施)已经成为企业算力建设的四大核心业务场景。不少方案商、企业 IT 与开发者在选型、POC 测试、上线部署阶段,会关注硬件切分、主流模型运行条件、任务调度逻辑、实测数据口径、硬件迁移、模型实操部署等落地细节。
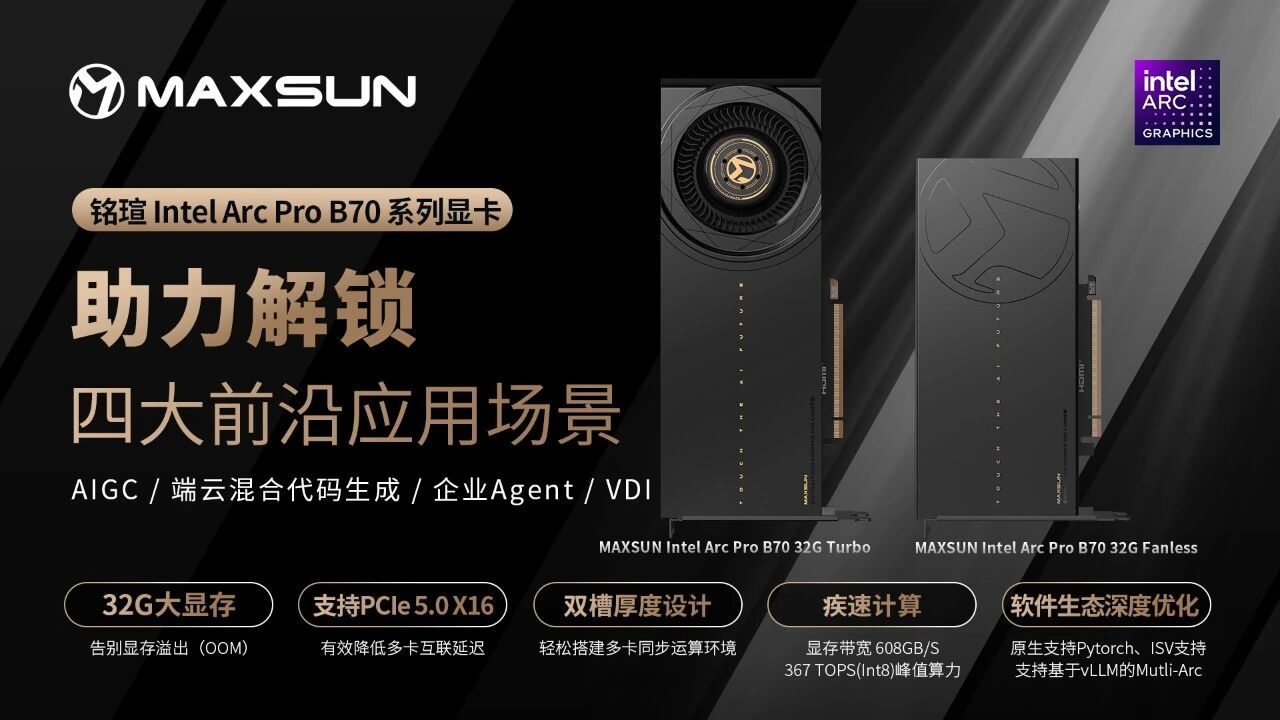
铭瑄 Intel Arc Pro B70 作为专业级的旗舰算力显卡,拥有 32GB GDDR6 超大显存、32 颗 Xe² 核心、367 TOPS INT8 算力、SR‑IOV 硬件虚拟化,同时兼容 vLLM、OpenVINO、ComfyUI、Docker 容器化部署工具。本文结合铭瑄实验室实测,梳理高频落地疑问,把8×4GB SR‑IOV vGPU 切分、Qwen3.8‑27B、MiniMax H3、端云任务路由、CUDA 生态迁移、两大主流模型本地部署实操的部署条件、测试口径做补充说明,帮助项目快速完成 POC 验证与正式上线。
一、关于迁移兼容性:
Q:原先使用其他显卡工作,如果换成 B70,迁移上会不会有什么问题?特别是 CUDA 相关?
A:B70 采用 SYCL/oneAPI 软件栈,而非 CUDA。这意味着:
- 主流框架可直接迁移:当前主流的推理框架(如 vLLM、llama.cpp、Ollama、ComfyUI)均已提供 XPU 后端适配,并提供对应的 Docker 容器镜像。采用这些框架的业务基本无需改造即可运行 。
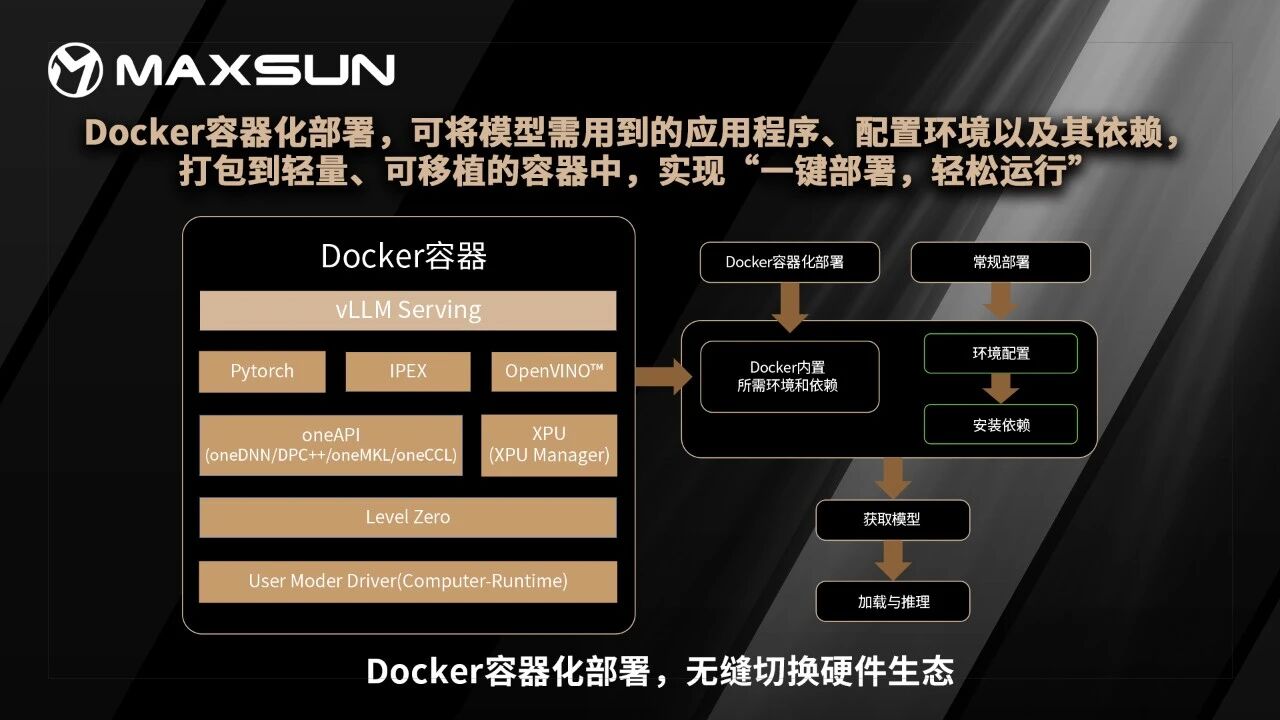
- 全模态推理有专属方案:对于视频生成等场景,官方提供的 LLM-Scaler-vLLM/Omni 容器已适配 MiniMax H3、LTX-2 等主流模型,可直接在 B70 上运行 。
- CUDA 独占工具需注意:如果业务依赖 CUDA 独占的框架或工具(如 TensorRT-LLM、部分 Marlin 反量化内核),则当前无法直接运行 。建议迁移前先评估业务栈对 CUDA 的依赖程度,并优先选择已提供 XPU 后端支持的方案。
核心建议:迁移成本主要集中在软件栈适配上,而非硬件本身。铭瑄可提供完整的 Docker 化部署指南,帮助用户平滑迁移至 Intel 生态。
二、MiniMax H3 全模态音视频生成部署 FAQ(面向AIGC场景)
Q:MiniMax H3 在 B70 上面本地部署,硬件条件、测试口径、限制条件?
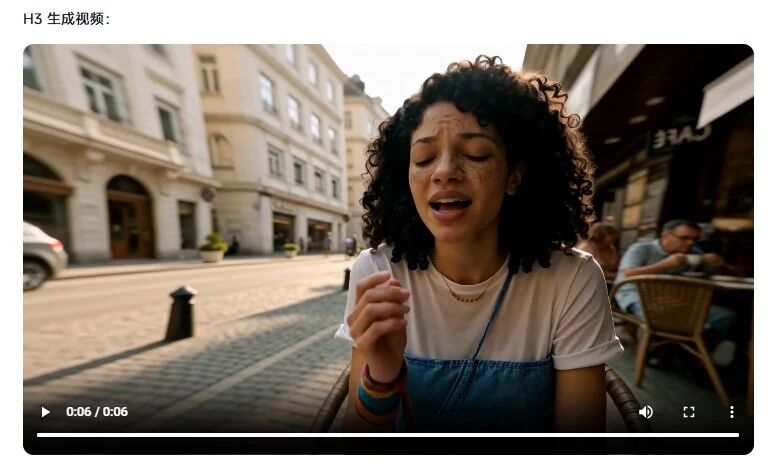
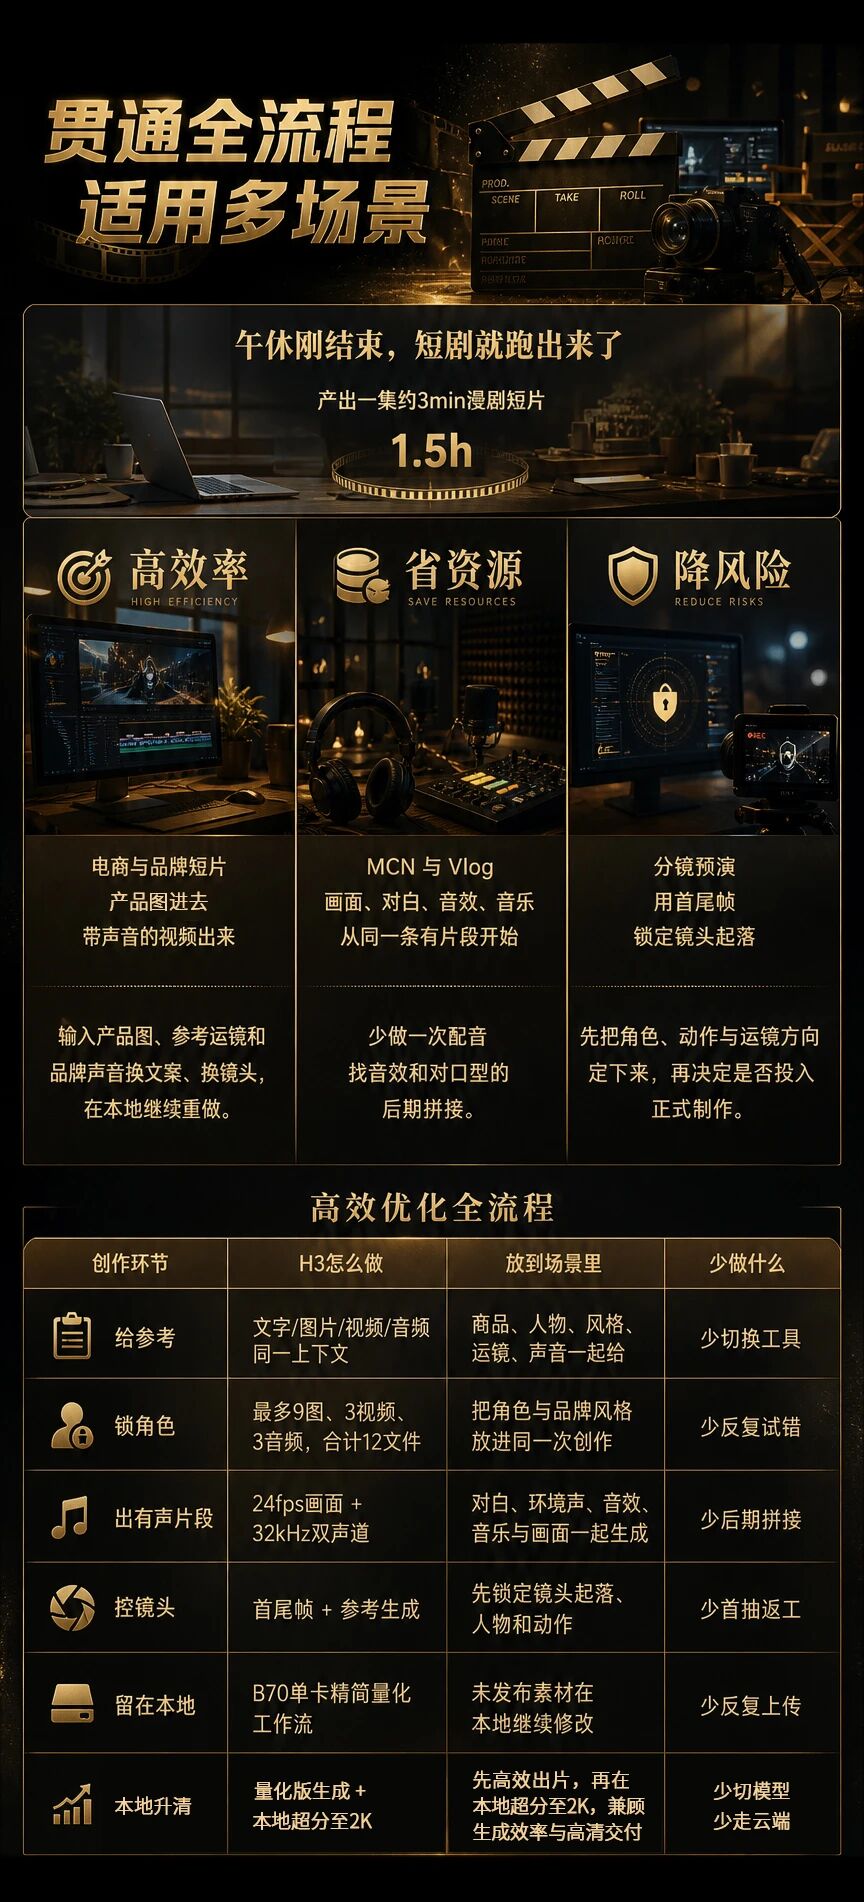
A:MiniMax H3 是开源全模态模型,支持文生图、文生有声视频、图生视频,原生输出画面 + 双声道音频,企业用于电商短片、MCN 素材、分镜预演等场景。
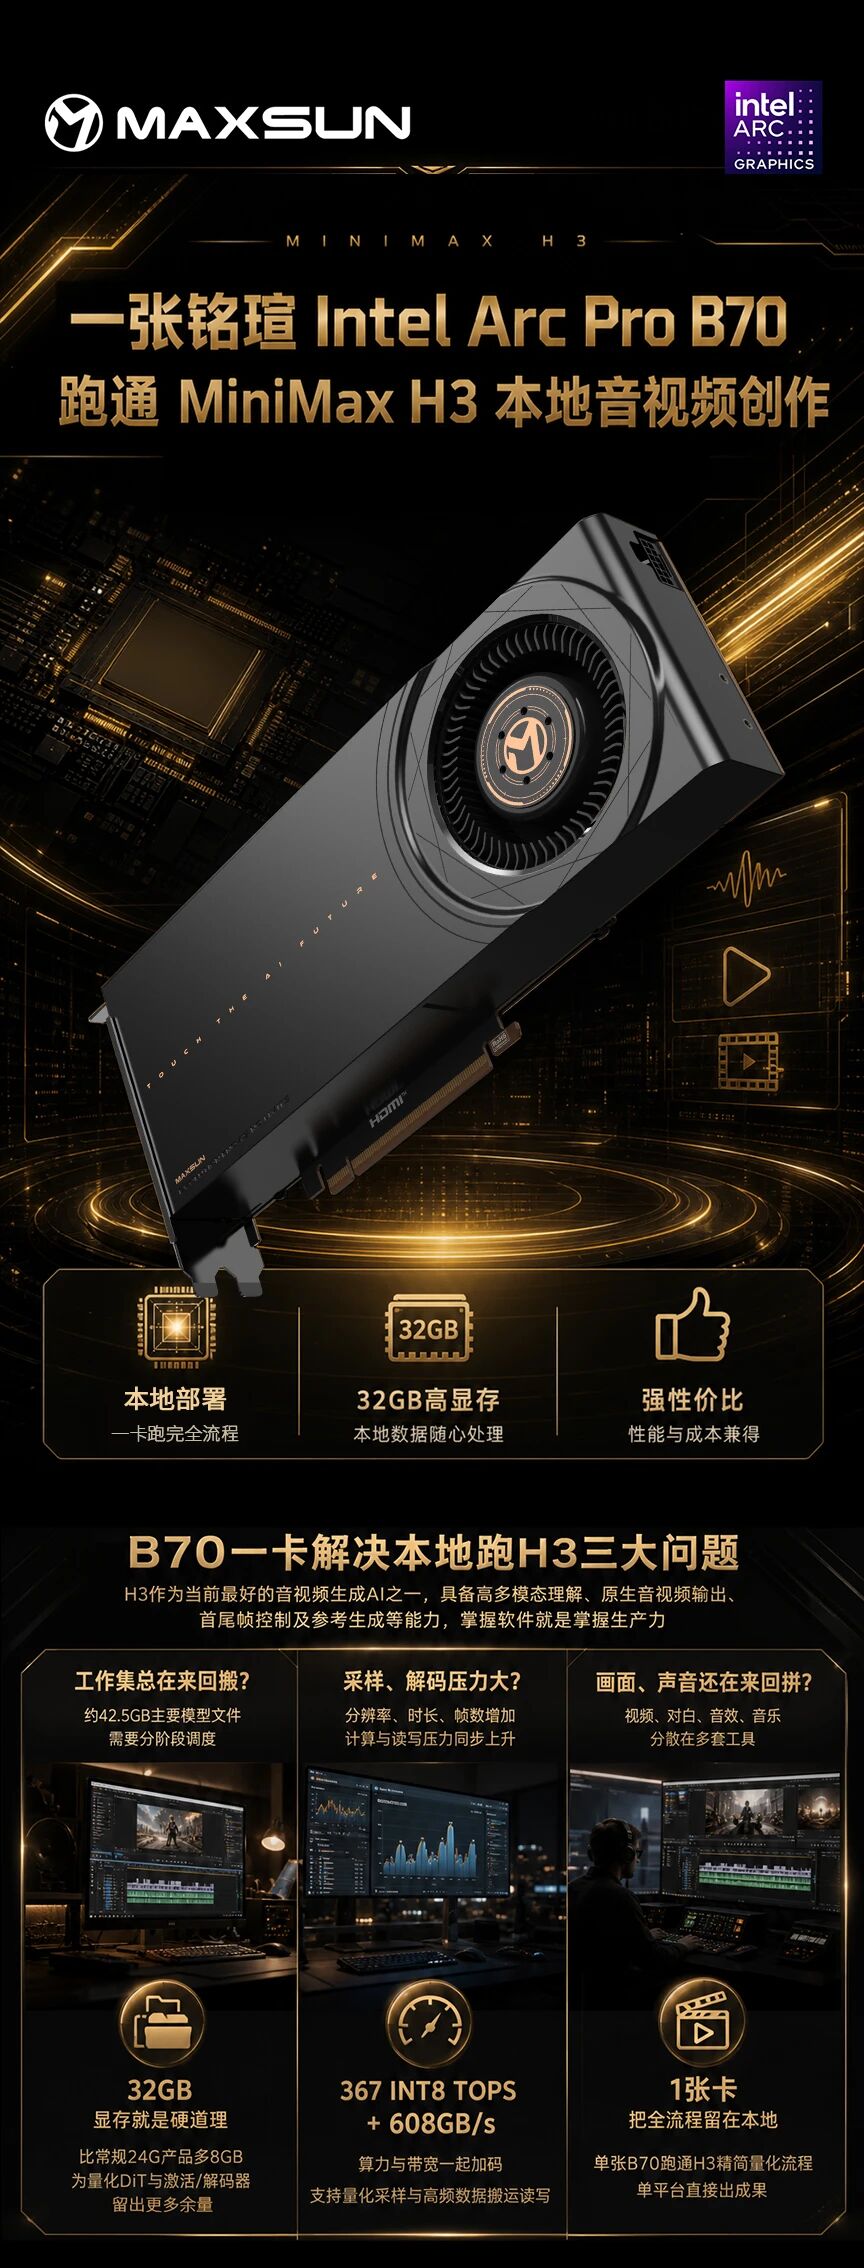
- 硬件基线:单卡铭瑄 Intel Arc Pro B70 32GB GDDR6,需要使用量化精简版本权重;原始 BF16 完整权重显存占用超过单卡容量,无法单卡直接加载。
- 软件口径:依托 LLM‑Scaler‑omni 套件,ComfyUI 工作流;双硬件编解码单元承担视频编码输出,不需要依赖 CPU 做转码。
- 铭瑄实验室实测:864×480 分辨率、5 秒时长,精简量化工作流,生成耗时约 153 秒;完整流程全部本地完成,画面、对白、音效、音乐在本地统一生成,素材不需要上传公网,保障企业未发布创意资产安全。
- 显存边界说明:运行时峰值显存最高接近 31GB,因此24GB 显存规格显卡会出现显存溢出 OOM,B70 的 32GB 显存是单卡跑该模型的重要基础条件。更长时长、更高分辨率视频,显存占用会同步上涨,需要调低参数或做多卡扩展。
- 特有优势:不只是生成画面,是完整音视频一体输出;企业可以私有化部署,规避云端 API 限流、网络波动、素材外泄风险。
Q:如何在铭瑄 Intel Arc Pro B70 本地部署 MiniMax H3?
A:推荐使用 ComfyUI + LLM‑Scaler‑omni 推理套件,部署步骤参考:
1、环境准备:安装 B70 显卡、XPU 驱动、oneAPI 运行环境;
2、部署适配 XPU 的 ComfyUI 环境,导入 LLM‑Scaler‑omni 组件;
3、获取 MiniMax H3 精简量化权重(不使用 BF16 原版权重),放置至模型对应目录;
4、加载官方适配 H3 工作流模板,不要使用第三方未适配工作流;
5、执行基础测试:输入提示词生成 864×480,5 秒时长有声视频,确认同时输出画面 + 双声道音频;
三、关于端云混合代码生成的任务路由策略
Q:如何定义“云端统筹、本地子 Agent 生成”的路由规则?成本上有什么优势?
A:建议采用分层任务路由策略:
- 本地执行:执行Agent任务、日常代码补全、语法纠错、私有代码库 RAG 检索、敏感上下文分析(由 B70 本地运行 Qwen3.8-27B 承担)。
- 云端执行:跨项目超长上下文深度推理、模块级复杂重构、顶层架构规划。
- 成本量化:据铭瑄实验室进行方案成本对比,采用端云混合代码生成解决方案能在三年内降低约80% Token成本。
- 路由依据:推荐采用动态性价比模型,实时权衡“本地模型能答对”与“云端模型更贵但更准”之间的代价,仅在本地置信度低于阈值时才路由至云端。
四、Qwen3.8‑27B 模型部署 FAQ(面向企业 Agent、端云混合代码生成场景)
Q:Qwen3.8‑27B 在铭瑄 Intel Arc Pro B70 上部署的硬件、软件、测试口径是什么?
A:1、 硬件基线:单卡 B70 32GB GDDR6;开启 ECC 显存纠错功能,适合 7×24 小时企业持续推理服务。
2、软件栈口径:基于 vLLM‑XPU 推理框架,Docker 容器化部署,支持 OpenAI 兼容 API 接口,可直接对接 IDE 插件、企业 Agent 中间件。支持 INT4/GPTQ 量化版本,不建议直接使用 FP16 原始权重,显存不足以完整加载。
3、上下文能力:原生支持256K 超长上下文窗口,可一次性读取大量项目源码、多份合同文档、整套项目资料,用于 RAG 知识库检索、代码库解析。
4、实测性能:Qwen3.8‑27B INT4 量化,单卡可实现稳定代码补全、工具调用、Agent 多步骤任务编排;可作为端云混合代码生成方案的本地子 Agent 模型,承接私有代码库检索、日常代码补全、语法纠错等高频本地任务,复杂全局重构任务交由云端路由出去处理。
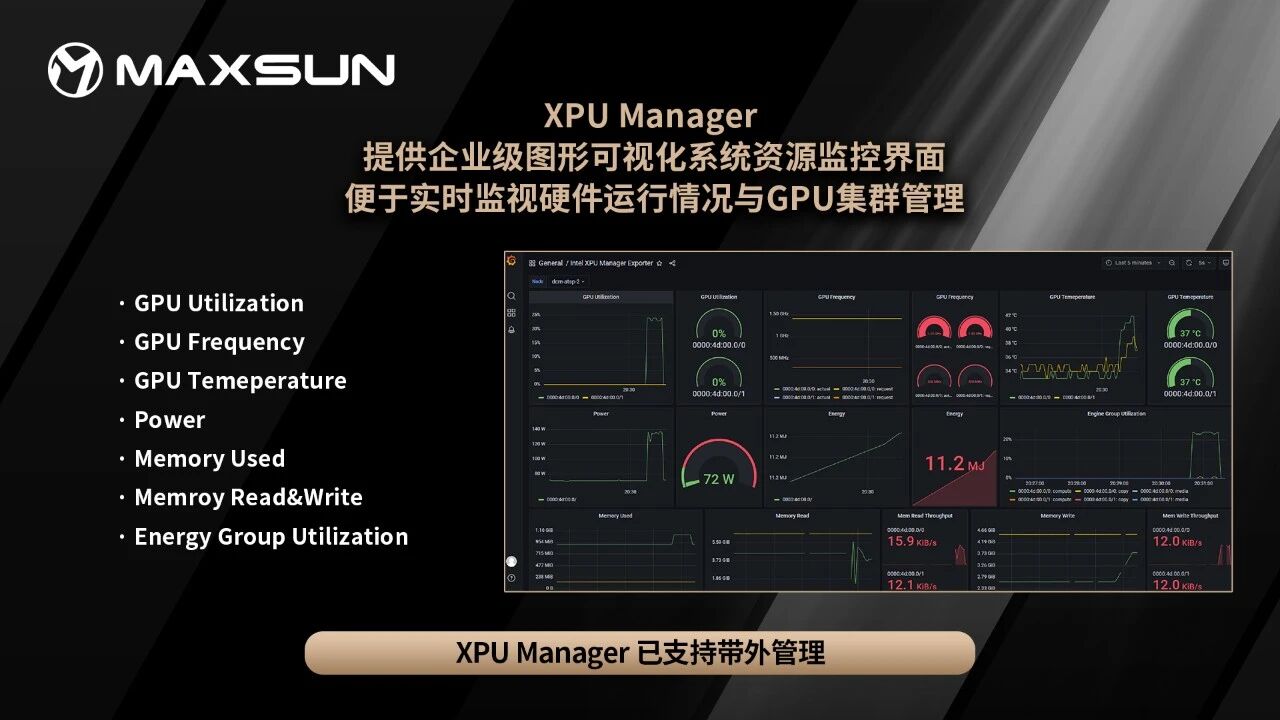
5、生产部署提示:如果并发用户数高,可多卡堆叠 B70,通过张量并行、数据并行进一步提升并发与吞吐量;XPU Manager 工具可以实时监控显存占用、GPU 利用率,方便运维排错调优。
五、SR‑IOV 虚拟化:8×4GB vGPU 切分部署 FAQ(面向 VDI 场景)
Q:铭瑄 Intel Arc Pro B70 支持 8×4GB vGPU 切分,该配置的部署前提是什么?
A:B70 原生支持 SR‑IOV 单根 I/O 虚拟化技术,可实现最多 8 个 4GB 显存的虚拟 GPU(VF)实例分配,用于 GPU‑VDI 多用户虚拟桌面场景。
1、操作系统要求:Host 宿主机建议采用 Linux 操作系统;Windows 宿主机需要升级至对应版本以上专业驱动,才完整启用 SR‑IOV 功能。虚拟机客户机支持 Windows、Linux。
2、 业务适配边界:8×4GB 更适合轻中度图形 VDI 场景:日常办公、2D 绘图、轻度 CAD 浏览。如果虚拟机内部同时还要跑 AI 推理、大模型任务,单 4GB vGPU 显存不足以承载大模型,需要调大单份 vGPU 显存、减少虚拟实例数量。
3、特有业务价值:B70 虚拟化并非只能做图形桌面;物理 PF 仍保留剩余算力,宿主机层面可同时运行 Agent、RAG 轻量推理任务,做到虚拟化桌面与后台 AI 算力硬件复用,提升服务器资源利用率。
铭瑄 Intel Arc Pro B70 凭借 SR‑IOV 硬件虚拟化、32GB 超大显存、强劲 AI 算力、完整软件生态,一套硬件覆盖AIGC、端云混合代码生成、企业Agent、以及VDI四大企业主流场景,大幅降低 AI 私有化项目落地门槛和成本,释放数字化业务价值。
(*注:文中数据均来源于铭瑄实验室,实际表现受操作系统、驱动版本、模型量化版本、上下文长度、服务器整机配置影响,存在合理浮动或部分差异)